1. 주목할 만한 AI 서비스 및 모델
DeepSeek-R1 (2025.01.20.)
중국 LLM의 반격, 저비용 고성능 모델의 등장
DeepSeek-V3을 기본 모델로 사용하고, GPRO(Group Relative Policy Optimization) 프레임워크를 활용한 강화 학습을 적용하여, Deepseek는 강화 학습만을 이용하여 언어 모델의 추론 능력을 향상시키는 것에 도전합니다. 이렇게 탄생한 Deepseek-R1-Zero는 벤치마크에서 좋은 성능을 보이지만, 가독성이 낮거나 언어가 혼합되는 문제가 발생합니다.
이를 개선하기 위해 단계별로 학습을 진행하며 개선을 진행하는 다단계 학습 파이프라인(Multi-stage Training Pipeline)을 도입합니다.
사전 학습 → 추론 중심 강화 학습 → 지도 학습 → 다양한 태스크에 대한 강화 학습
DeepSeek-R1은 여러 벤치마크에서 뛰어난 성능을 보입니다. 수학 문제 해결, 코딩 작업, 사실 기반 질문 등 고차원적인 작업에서도 높은 점수를 보였고, 창의적 글쓰기, 질의 응답, 요약 등의 일반적인 작업에서도 우수한 성능을 보였습니다. 특히, 긴 문맥 처리 벤치마크에서는 Deepseek-V3보다 더 높은 성능을 보이면서, 복잡한 텍스트를 다룰 수 있는 능력도 입증되었습니다.
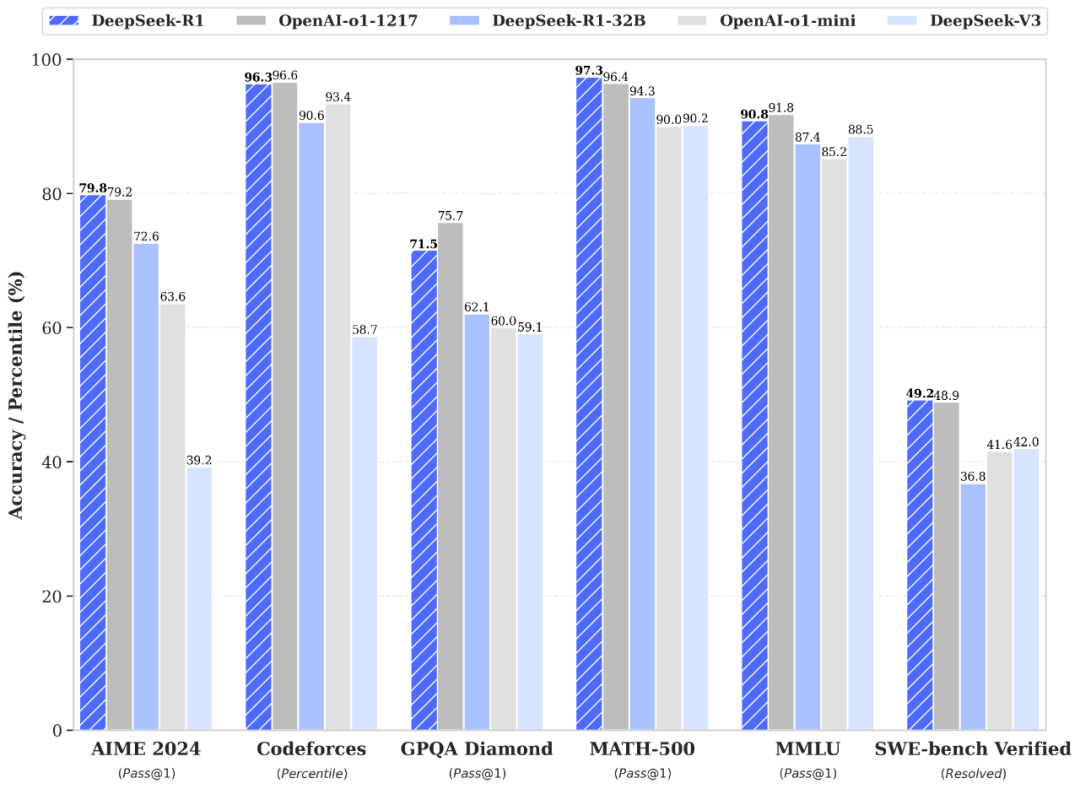
DeepSeek-R1은 중국 항저우에 위치한 인공지능 스타트업 DeepSeek이 2025년 1월 공개한 대형 언어 모델로, 지도 학습(SFL, Supervised Fine-tuning) 없이 강화 학습(RL, Reinforcement Learning)만으로 학습된 것이 특징입니다. 미국의 AI 칩 수출 규제 정책으로 인해 고사양 GPU가 아닌 저사양 GPU H800을 사용하였음에도 불구하고, 다양한 벤치마크에서 OpenAI의 o1와 유사한 수준의 추론 성능을 보여주어 큰 주목을 받았습니다.
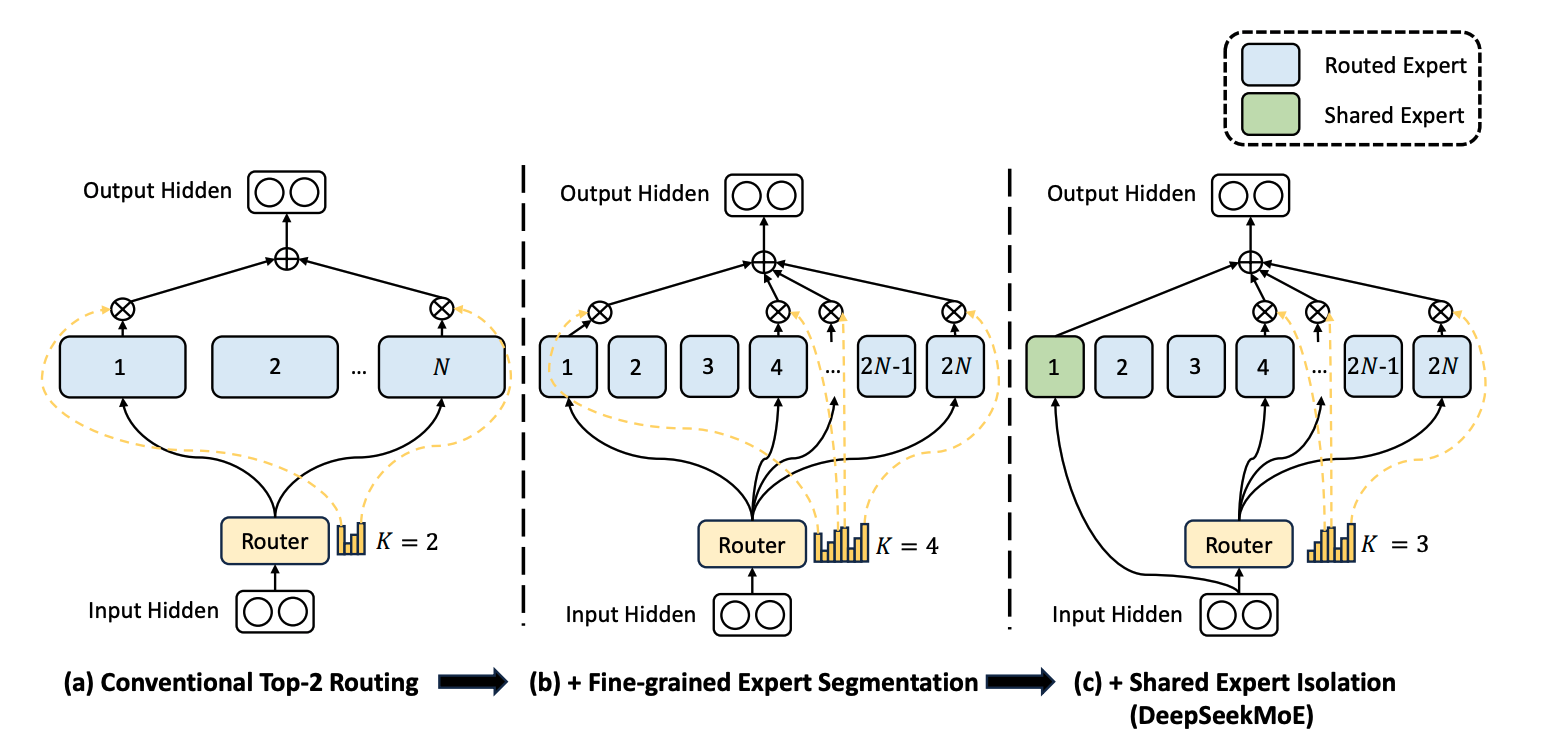
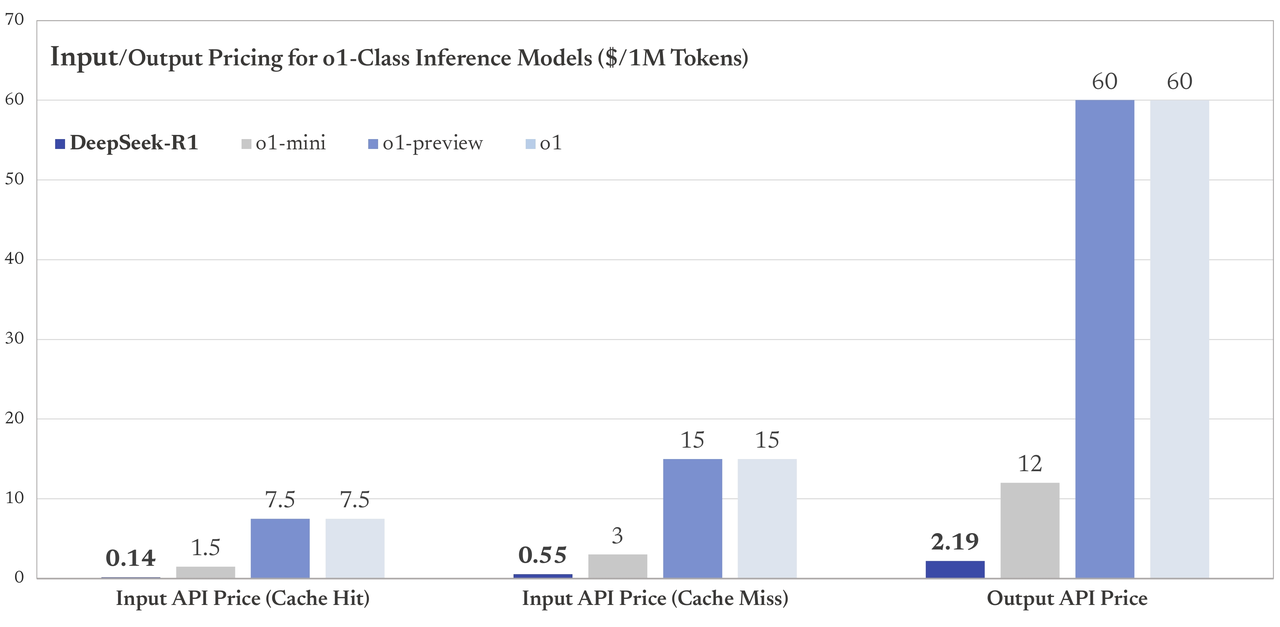
DeepSeek-R1이 크게 주목받은 이유 중 하나는 저렴한 비용인데요, MoE(Mixture of Experts) 구조를 사용하여 태스크에 맞는 전문가 모듈만 사용되게 함으로서 계산 효율성을 높이고 리소스를 절약합니다. 또한, 모델 훈련에 약 600만 달러(한화 약 80억)만 투자했는데, 이는 Meta가 AI 개발에 투입한 비용의 10분의 1 수준, OpenAI가 GPT-4 개발에 투입한 비용의 18분의 1 수준에 불과합니다. 더 놀라운 점은 이 모델들을 오픈소스로 공개했다는 점인데요, 이를 통해 AI 개발자와 연구자들이 고성능의 모델을 자유롭게 사용하고 수정할 수 있게 되었습니다.
DeepSeek-R1은 미국 중심의 AI 생태계에서 벗어나, 아시아권에서 자체 기술력을 기반으로 세계적 수준의 모델을 만든 첫 사례로 평가됩니다. 그러나 학습 데이터와 학습 과정은 공개하지 않아 오픈소스로 보기 어렵다는 지적, OpenAI 모델로 만든 합성 데이터를 활용했다는 비판, 그리고 학습에 투자한 비용을 축소하여 발표했다는 의혹이 제기된 만큼, ‘저비용 고성능’의 진정성에 의문을 품을 필요가 있어보입니다.
🔗 참고 링크
DeepSeek-R1 Release | DeepSeek API Docs
GitHub - deepseek-ai/DeepSeek-R1
deepseek-ai/DeepSeek-R1 · Hugging Face
GPT-4.5 (2025.02.27.)
OpenAI의 마지막 비추론 모델